TPU의 구조 개략
TPU는 구글이 자랑하는 AI 서비스용 특수 칩이다.
구글이 자랑하는 엄청난 가성비와 성능도 TPU에 기반해서 나오는 부분이 크다.
도대체 어떤 구조를 갖고 있길래 이게 그렇게 효율을 뽑아낼 수 있다는 걸까?
사실 구글이 TPU를 대외적으로 직접 팔거나 내부구조를 공개하지는 않기 때문에, 대략적인 정도로만 추측해볼 수 있다. 이건 사용자들이 써보면서 알아낸 것들, 그리고 대외적으로 공개된 정보들을 정리해본 글이다.
기본 구조
하나의 TPU 칩에는 텐서 코어라는 것이 몇개 들어있다.
GPU가 수천개의 초소형 코어를 박아대는 것과 약간 대비되게, 독립적인 코어를 1-2개 정도만 둔다. 물론 내부적으로는 소형 cell들이 수천-만 단위로 있기 때문에 결과적인 병렬 수준은 다르지 않다.
다음은 TPUv4의 이론적인 구조도다.
약간 구식이긴 한데, 아직 현역이고, 그 다음 버전들도 큰 틀에서는 크게 다르지 않다.
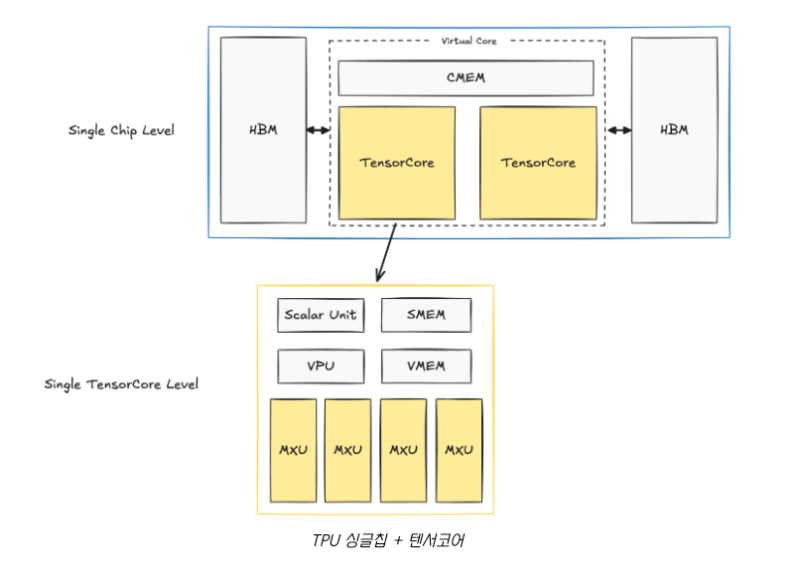 TPUv4 기준 설계도 (https://henryhmko.github.io/posts/tpu/tpu.html)
하나의 칩에는 1-2개 정도의 텐서코어가 박혀있고, 각각의 텐서코어에는 텐서 명령어를 빠르게 처리할 수 있는 전용 프로세서와 메모리 계층이 집적되어있다. 결국 중요한 것은 텐서코어다.
저기서 실제로 행렬연산을 처리하는 주체는 "MXU"라는 것이다. 보통 128x128이나 256x256 단위의 행렬 연산 cell이 박혀있고, 이 cell들로 행렬 연산을 돌리는 단위를 systolic array라고 부른다.
VPU는 벡터간 일반 연산을 담당한다. - 요소간 덧셈, 곱셈 등. 행렬연산 아님
스칼라 유닛은 비교적 단순한 스칼라 연산을 처리하는 작은 CPU다.
전반적인 동작 제어나 주소 제어 등을 담당한다.
SMEM/VMEM은 각각 스칼라 유닛 전용 메모리/벡터 연산 전용 메모리다.
당연히 성능에 주요한 것은 VMEM이다. 여기에 벡터를 밀어넣으면 VPU와 MXU가 벡터 연산을 빠르게 처리하는 것이다.
암시적인 캐시 의존도 낮음
TPU는 GPU/CPU와는 다르게 하드웨어 수준 캐시메모리 계층에 크게 의존하지 않는다.
이건 특유의 철학과 방향성에서 기인하는데, 유연성을 포기하는 대신 성능을 최대한 예측 가능한 수준에서 가져가는 것이 목적이었기 때문이다.
TPU에 모델을 올릴 때는 AOT나 JIT를 써서 컴파일-최적화 과정을 거치고, 컴파일 시점에 모든 캐싱 패턴을 명시적으로 처리한다.
그리고 이 덕분에 전력 대비 성능도 크게 높일 수 있었다고 한다.
메모리 계층
최초로 외부에서 데이터를 집어넣을 때는 HBM에 적재한다. 근데 HBM은 외부 메모리라서 코어에서 처리하기엔 느리다. 그래서 코어에 집적되어있는 VMEM으로 조금씩 옮기면서 처리를 한다.
(v4 기준) HBM은 32GB 정도의 기가급이고, VMEM은 128MB 정도 된다.
SparseCore
저기 위 그림에는 없는데, 사실 텐서코어와 같은 레벨로 SparseCore(희소코어)라는 것이 따로 있다.
이건 거대한 임베딩 데이터셋에서 일부 영역만 조회하는 용도로 사용된다.
이런거 말이다.
embedding_table[user_id]
embedding_table[item_id]
embedding_table[category_id]
이건 추론에는 잘 안쓰고. 학습 과정에서 쓰인다.
그래서 학습과 추론 장비가 분리된 v8부터는 학습 버전에만 달린다.
TPU vs GPU?
방향성이 약간 다른데, 지금에 와서는 GPU에도 텐서 전용 하드웨어(텐서코어)가 생겨서 좀 비슷해진 경향도 있다.
TPU는 거대한 행렬곱 하나하나를 빠르게 처리하기 위한 구조로 큰 단일 텐서코어를 집적하는 방향성을 취하고 있고, GPU는 작은 코어들로 병렬처리해서 처리량을 늘리는 방향으로 발전했(었)다.
그리고 GPU는 아직 그래픽카드라는 정체성을 버리지 않았기 때문에, 그래픽 연산을 포함한 이런저런 잡다한 기능을 가져가고 있다. cuda도 있고, 이런 범용성 면에서는 GPU에 우위가 있다.
비용적인 것은 구글이 자체한 내부사항을 공개하거나 외부 판매를 하지 않기 때문에 정확한 것은 내부자만 안다.
확실한 것은 전력 사용량이나 생산 단가는 TPU가 GPU보다 훨씬 저렴하다는 것이다. 거의 2배 가까이?
버전별 변경사항
(본인들이 주장하기로는) 버전마다 꽤 큰 향상들이 이어지고 있다.
v5부터는 효율성 버전과 고급 버전을 v5e, v5p 같은 식으로 나눴다가 최근에는 그걸 그만두고 또 추론용과 학습용을 분리하고 있다. 이랬다저랬다...
TPU v4 (2022)
- 칩 하나에 텐서코어 2, 희소코어 4개
- 텐서코어 하나에 MXU 4개
- MXU 하나는 128×128
- HBM: 32 GiB
- 칩당 성능: 275 TFLOPS (BF16)
TPU v5p (2023)
- 칩 하나에 텐서코어 2개, 희소코어 4개
- 텐서코어 하나에 MXU 4개
- MXU 하나는 128×128
- HBM: 95 GiB
- 칩당 성능: 459 TFLOPS (BF16)
TPU v6e (2024)
- 칩 하나에 텐서코어 1개, 희소코어 2개
- 텐서코어 하나에 MXU 2개
- MXU: 256×256
- HBM: 32 GiB
- 칩당 성능: 918 TFLOPs (BF16)
- v6p 버전 미공개
TPU v7x (2026)
- 칩 하나에 텐서코어 2개, 희소코어 4개
- 텐서코어 하나에 MXU 4개
- MXU: 256×256
- HBM: 192 GiB
- 칩당 성능: 2,307 TFLOPs (BF16)
- (제한사항) GKE로만 실행 가능
TPU v8
- 학습용 칩과 추론용 칩을 분리한 버전
TPU v8t
- 학습용 칩
- 텐서코어 ?개, 희소코어 ?개
- 4비트 부동소수점 지원
- MXU: 모름
- HBM: 216 GiB
- 칩당 성능: 12.6 PFLOPS (FP4)
- GCP 미지원
TPU v8i
- 추론용 칩
- 텐서코어 ?개, 희소코어 0개 (희소코어 없음)
- 4비트 부동소수점 지원
- MXU: 모름
- HBM: 288 GiB
- 칩당 성능: 10.1 PFLOPS (FP4)
- GCP 미지원
참조
https://henryhmko.github.io/posts/tpu/tpu.html
https://docs.cloud.google.com/tpu/docs/system-architecture-tpu-vm?hl=ko
https://cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive?hl=en
https://docs.cloud.google.com/tpu/docs/system-architecture-tpu-vm?hl=ko#sparsecore