[Clickhouse] Update와 중복 제거
clickhouse는 여러모로 참 좋은 DB지만, 가장 취약한 부분이 UPDATE에 대한 처리다.
그래서 데이터의 지속적인 통합이 필요한 경우에 사용한다면 이 부분을 잘 이해하고 써야 한다.
Mutation의 비효율성
일단 Clickhouse도 다른 DB들처럼 데이터의 Update 기능을 제공하긴 한다.
문제는 이게 Clickhouse의 본질적인 한계점을 건드리는 부분이라서 다른 DB들에 비하면 매우 비효율적이란 것이다.
https://blog.naver.com/sssang97/224211356504
왜일까? Clickhouse는 데이터를 수천개를 하나의 블럭으로 묶어서 압축 저장하고 읽는 식으로 처리를 한다.
그래서 행 하나를 수정한다고 해도, 그 블럭을 통째로 분해한 다음에 빼고 블럭 재구성을 다시 하는 무거운 작업을 돌려야 하는 것이다. 행 단위로 딸깍 덮어쓰고 나오는 여타 DB들과는 많이 다르다.
그런 까닭에 clickhouse의 update는 즉시 동작이 아니라, mutation 큐를 두고 비동기적으로 처리되는 방식을 갖고 있는 것이기도 하다.
mutation은 그냥 수동으로 몇개씩 수정하고 그럴 때만 사용하고, 실시간 통합에서 사용할 생각은 하지 않는 것이 좋다.
이에 대한 권장되는 접근법은, 행을 수정하는 것이 아니라 동일한 ID의 새 값을 INSERT한 뒤에 점진적으로 MERGE해서 최종적인 유일성만을 가져가는 것이다. CollapsingMergeTree나 ReplacingMergeTree를 사용하면 이를 달성할 수 있다.
엔진: CollapsingMergeTree (애매함)
CollapsingMergeTree는 중복 배제를 위한 변형 엔진 중 하나다.
근데 사용법이 기묘하고 직관적이지 않아서 활용도는 낮다. 홀/짝 형태로 버전값을 넣으면 쌍소멸시키는 신기한 형태로 청소를 처리한다.
https://blog.naver.com/sssang97/223987183385
이런게 있다는 것만 알아도 된다.
엔진: ReplacingMergeTree (추천)
ReplacingMergeTree는 UPDATE에 대한 가장 실용적이고 편리한 대안이다.
동일 ID로 데이터가 여러개 있으면, 적당히 최신 것만 하나 남기고 정리해주는 식으로 동작한다.
https://blog.naver.com/sssang97/223926254595
근데 문제는, 이 중복제거-MERGE가 실시간성이 보장되는게 아니라는 것이다.
MERGE는 기본적으로 알아서 필요할 때만 돈다. 그래서 MERGE가 돌기 전까지는 중복이 존재할 수 있다.
여기서 중복을 배제하는 것에는 몇가지 방법이 있다.
그냥 수동으로 OPTIMIZE FINAL을 날려서 MERGE를 트리거하는 것도 임시조치로는 쓸만하지만, 지속 가능하지 않다. 너무 느리고 부하를 많이 주기 때문에 데이터 규모가 클수록 현실적이지 않다.
1. Limit By절 (비추천)
clickhouse는 중복배제에 대한 문법적 설탕을 몇가지 제공하는데, 대표적인 것이 limit by다.
limit by 1로 걸면 최신 데이터를 하나씩만 가져오도록 할 수 있다.
select *
from 테이블
limit by 1;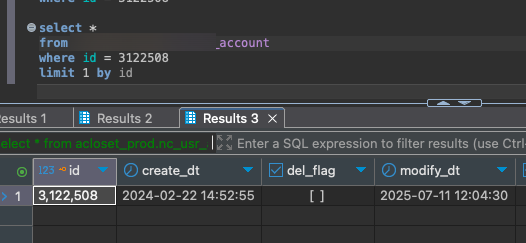 다만 이건 정렬순으로 가져오기 떄문에 로직이 정렬과 연관되어있다면 쿼리가 좀 복잡해진다.
2. FINAL 절
clickhouse의 SELECT 문법에는 FINAL이란 것이 또 있다.
테이블명 오른쪽에 붙이면 되는데, 그러면 최신 데이터만 남기고 하나씩만 조회되게 한다.
SELECT *
FROM 테이블명 FINAL
...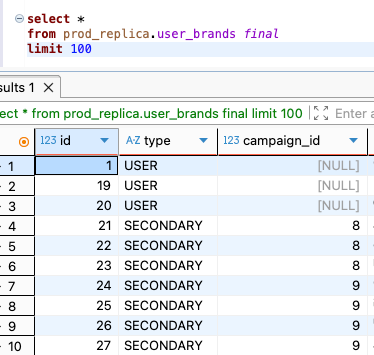 이것도 결과적으로는 limit by 1과 비슷한 역할을 한다.
인메모리에서 최신 데이터만 남기고 중복제거를 하는 것이다.
그냥 쿼리에 비해서는 부하가 좀 있지만, 막 엄청 크지는 않다.
그리고 이건 실제로 MERGE를 돌리는건 아니고, 현재 읽기분에 대해서만 중복제거를 돌려서 읽기 결과에만 반영해주는 것이다.
3. min_age_to_force_merge_seconds
MergeTree의 테이블 설정 중에 min_age_to_force_merge_seconds라는 것이 있다.
ALTER TABLE 테이블명
MODIFY SETTING min_age_to_force_merge_seconds = 10 # 10초
저 시간이 지난 데이터 세트에 대해서는 항상 merge를 하라는 명령인데, 중복제거에도 응용할 수 있다.
저걸 10분으로 걸면, 10분이 지난 값들에 대해서는 거의 중복 제거를 보장할 수 있다.
단점은 실시간성이 부족하다는 것과, merge로 인해 성능 부담이 늘어날 수 있다는 것 2가지다.
너무 빠듯하게 돌리면 디스크나 CPU 부하가 병목지점이 될 수 있고, 결국 10분 이내의 최근 값들은 중복이 얼마든지 존재할 수 있다.
그래서 이건 데이터 통합이 간헐적이거나, 데이터 통합과 사용 시간을 배제적으로 구성할 경우에 효율적이다.
2번과 3번을 적절히 조합해서 사용하는 것도 꽤 효율적일 수 있다.
min_age_to_force_merge_seconds를 1시간으로 걸고 쿼리마다 FINAL을 걸면, 1시간 이전 데이터를 효율적으로 타고 1시간 이내의 최신 데이터에 대해서만 인메모리 dedup이 돌 것이니, 비교적 부하가 적어진다.
참조
https://blog.naver.com/sssang97/223929932221
https://clickhouse.com/docs/reference/statements/select/from#final-modifier