[k8s] 쿠버네티스와 OOMKill
쿠버에서 메모리 초과가 발생했을때 컨테이너가 죽는 방식, 원리를 정리한다.
Pod가 OOM으로 죽는 경로는 대략 3가지가 있다.
- Pod의 Limit으로 인한 OOM Kill (by cgroup)
- Node 자원 고갈로 인한 OOM Eviction (by kubelet)
- Node 자원 고갈로 인한 OOM Kill (by Linux Kernel)
1번은 그리 어려울 것이 없다.
컨테이너 정의에 memory limit을 적어놨는데 그걸 넘는다면 OOM으로 즉시 사망한다. 이건 기본 컨테이너 스펙 - cgroup의 동작에 기반해서 제어된다.
2번은 쿠버가 마련해둔 최소한의 안전장치다. 노드의 메모리가 정말 꽉차면 리눅스커널이 개입해서 모든걸 멈추고 정리를 시작한다. 정리대상에서는 쿠버 에이전트도 예외가 아니므로, 죽이더라도 쿠버에서 빨리 죽이고 정상화하는 것을 원한다.
그래서 kubelet이 개입해서 OOM으로 죽이는 것이다.
3번은 당연히 OS에서 죽이는 것이다. 여기까지 오면 절반쯤은 장애상황이라 봐도 된다.
쿠버는 가급적 여기까지 오지 않게 하려고 노력은 하지만, 메모리 증가가 너무 급격하다면 여기로 올 수도 있다.
여기서 주요하게 다룰만한 것은 2번이다. 1번이나 3번은 뭐 이야기할 것이 따로 없다.
kubelet의 Pod Eviction (OOM)
상기했듯이 쿠버는 노드에 리소스(메모리나 디스크)가 부족해지면 리소스를 확보하기 위해 Pod를 죽인다. 이걸 pod eviction이라고 부르는데, kubelet에 의해서 처리된다.
여기서는 아무거나 막 죽이는게 아니라, 내부적인 우선순위와 스코어를 통해 처리된다.
Pod에는 사실 QoS라는 것이 있고 이게 oom_score_adj라는 값의 소스 중 하나로 사용된다.
https://blog.naver.com/sssang97/224425759200
그리고 QoS에 따라서 다음과 같이 oom_score_adj가 할당된다.
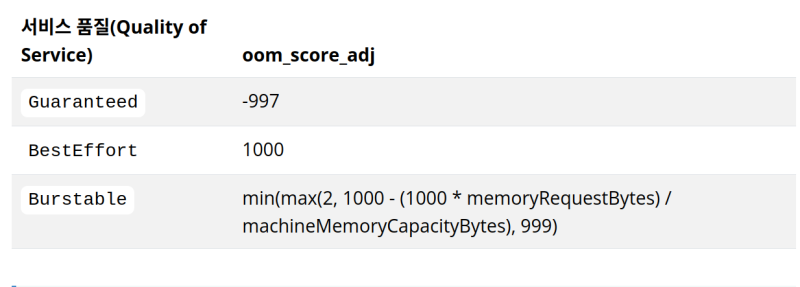 https://kubernetes.io/ko/docs/concepts/scheduling-eviction/node-pressure-eviction/#%eb%85%b8%eb%93%9c-%eb%a9%94%eb%aa%a8%eb%a6%ac-%eb%b6%80%ec%a1%b1-%ec%8b%9c%ec%9d%98-%eb%8f%99%ec%9e%91
당연히 점수가 높은 것부터 죽인다.
Burstable은 좀 복잡해보이는데, 아무튼 메모리 크기가 클수록 점수가 크되, 그 상한이 999로 정해진 것이다.
그리고 좀 헷갈릴 수 있는데, OOM Kill을 선택하는 기준은 oom_score_adj가 아니라 oom_score_adj에서 파생된 oom_score라는 값이다.
oom_score는 실제 사용량이 request를 넘으면 증가하기 때문에, request를 넘었다면 burstable이 BestEffort보다 먼저 죽을 수도 있다.
참조
https://blog.naver.com/alice_k106/221676471427
https://blog.naver.com/sssang97/224425759200
https://kubernetes.io/ko/docs/concepts/scheduling-eviction/node-pressure-eviction/